Cùng một bài, đọc bằng chữ. Nhanh hơn và tìm lại được bằng Ctrl+F.
Model AI là nhiều layer xếp chồng
Mỗi layer là một khối số đã học sẵn. Câu hỏi của bạn đi qua layer đầu, rồi layer sau, cứ thế đến layer cuối.
70B nghĩa là cả model có 70 tỉ con số như vậy.
Cả model phải nằm trong VRAM
VRAM là bộ nhớ trên card đồ hoạ. GPU trên card chỉ tính được với số nằm trong VRAM. Nên thường mọi layer phải nằm sẵn ở đó.
Model 70B không vừa card 4 GB theo cách này.
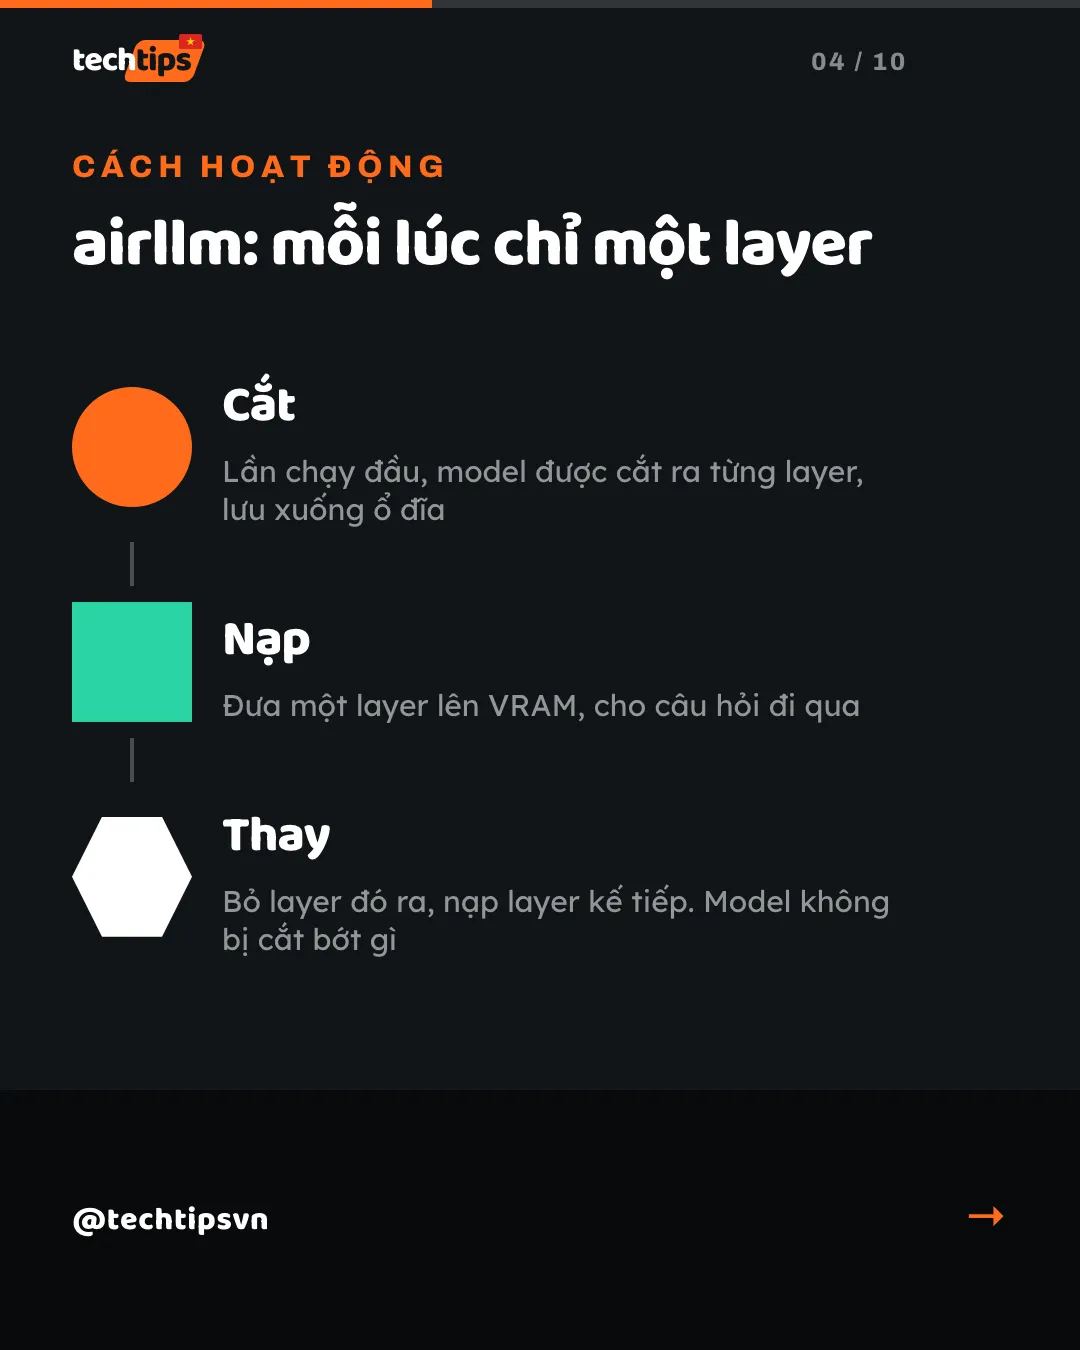
airllm: mỗi lúc chỉ một layer
- CắtLần chạy đầu, model được cắt ra từng layer, lưu xuống ổ đĩa
- NạpĐưa một layer lên VRAM, cho câu hỏi đi qua
- ThayBỏ layer đó ra, nạp layer kế tiếp. Model không bị cắt bớt gì
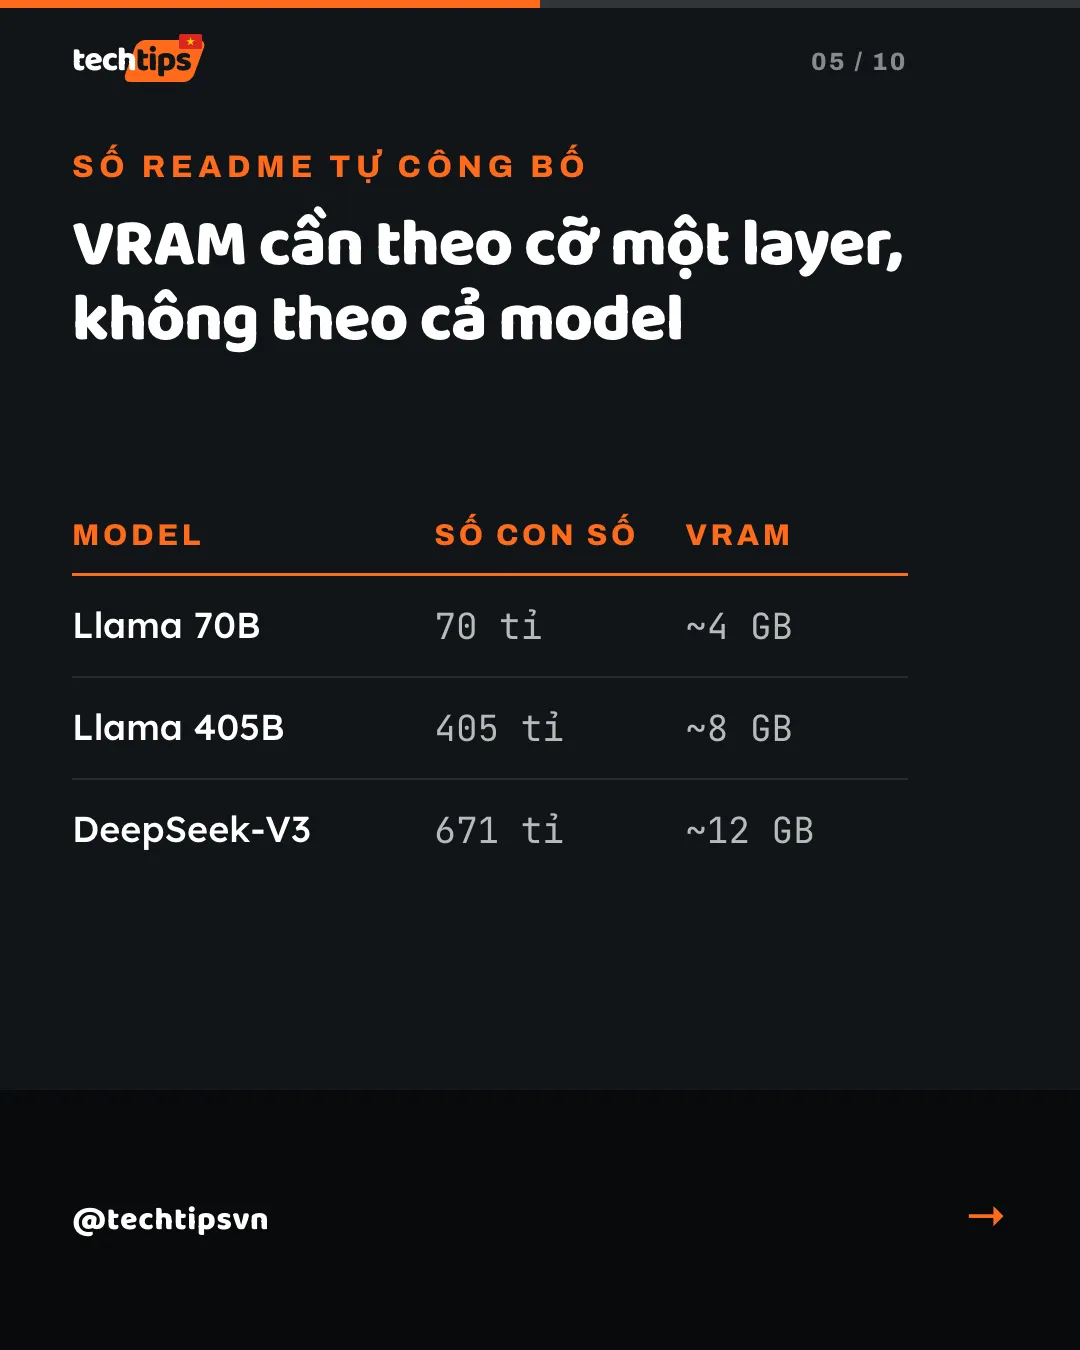
VRAM cần theo cỡ một layer, không theo cả model
| Model | Số con số | VRAM |
|---|---|---|
| Llama 70B | 70 tỉ | ~4 GB |
| Llama 405B | 405 tỉ | ~8 GB |
| DeepSeek-V3 | 671 tỉ | ~12 GB |
Cái giá thứ nhất: ổ đĩa
Lần chạy đầu, airllm lưu thêm bản đã cắt cạnh bản gốc tải về. README dặn chuẩn bị nhiều chỗ trống trên ổ. Đặt delete_original=True để xoá bản gốc.
Cái giá thứ hai: thời gian
Mỗi câu trả lời phải đọc lần lượt từng layer từ ổ đĩa lên VRAM. README tự nhận chỗ chậm nhất là đọc ổ đĩa. README không công bố tốc độ.
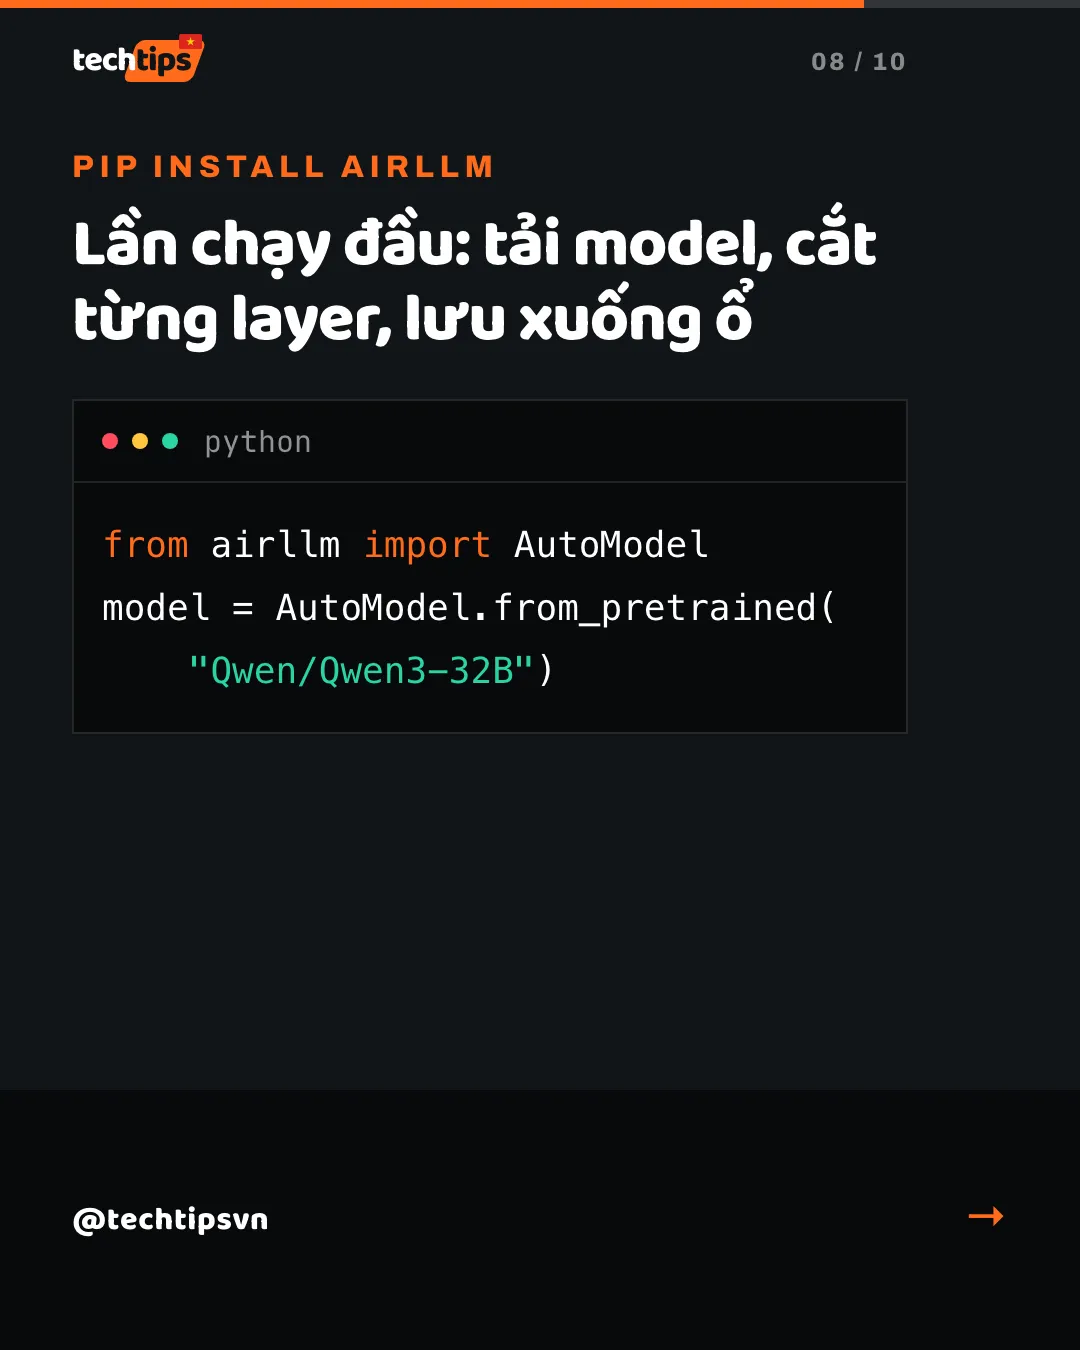
Lần chạy đầu: tải model, cắt từng layer, lưu xuống ổ
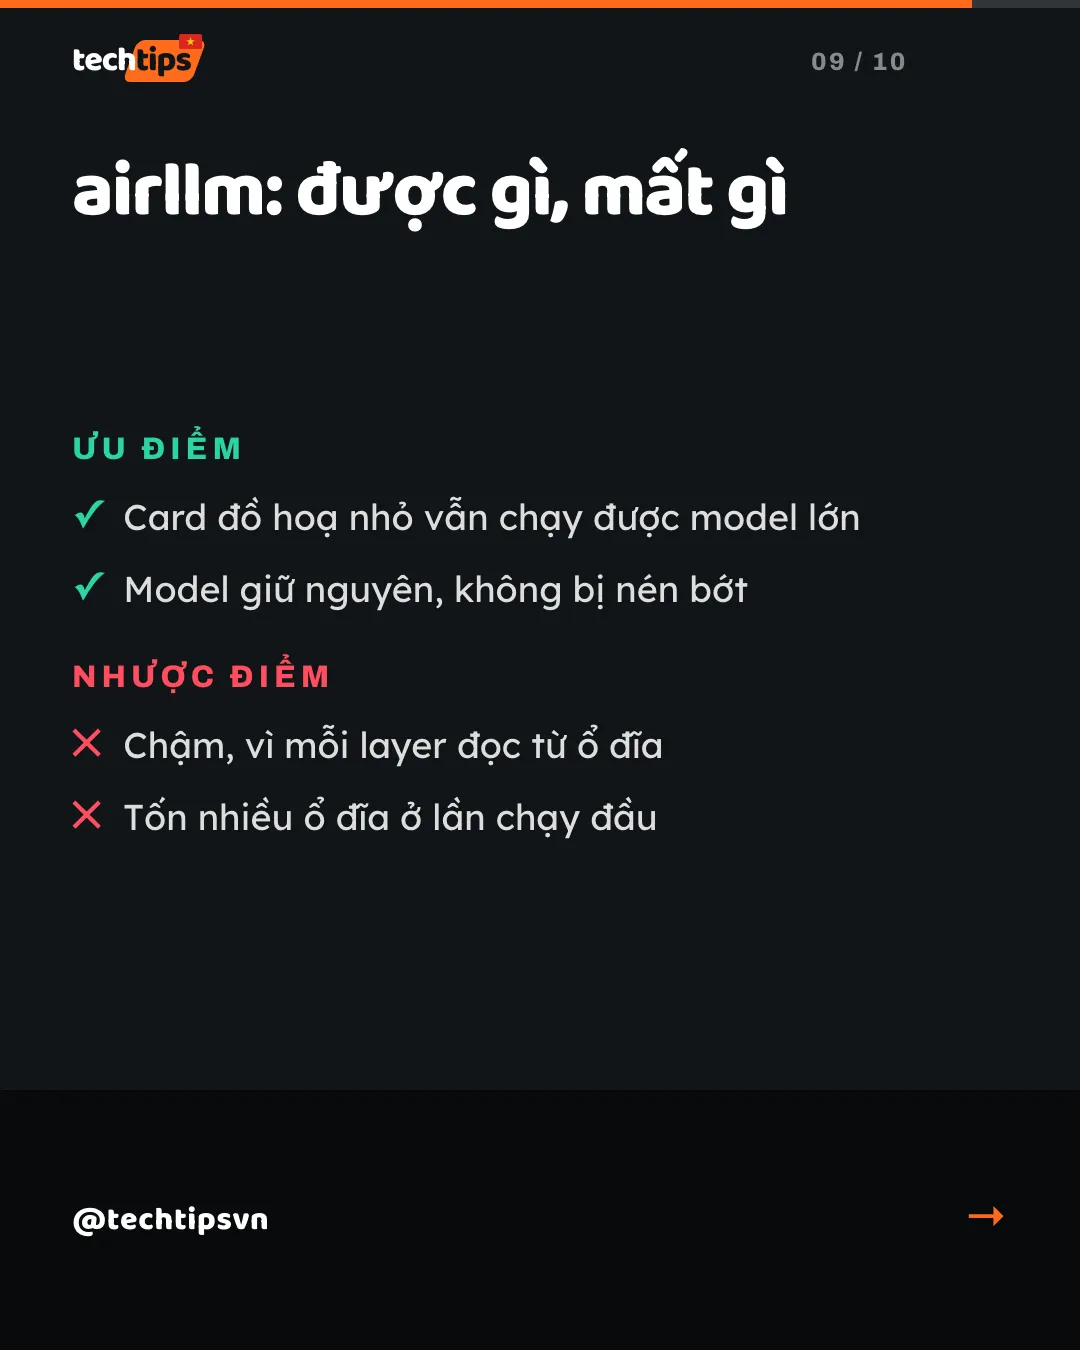
airllm: được gì, mất gì
Ưu điểm
Card đồ hoạ nhỏ vẫn chạy được model lớn
Model giữ nguyên, không bị nén bớt
Nhược điểm
Chậm, vì mỗi layer đọc từ ổ đĩa
Tốn nhiều ổ đĩa ở lần chạy đầu
Trước khi thử, xem ổ đĩa còn trống bao nhiêu
Thấy repo nào hứa model lớn trên card nhỏ, hỏi luôn hai câu: tốn bao nhiêu ổ đĩa, và chờ bao lâu cho một câu trả lời.